Em março de 1990, um professor de economia de Princeton chamado Orley Ashenfelter afirmou que conseguia prever a qualidade de um vinho de Bordeaux sem prová-lo.
Bastavam a idade da safra e alguns dados do clima: a temperatura e a chuva do ano em que a uva cresceu.
A reação do mundo do vinho não foi das melhores. Robert Parker, o crítico mais influente da época, chamou Ashenfelter de "an absolute total sham" (uma fraude completa) e o comparou a um crítico de cinema que não vê o filme, mas diz se ele é bom a partir dos atores e do diretor.
Então vieram as previsões. Parker considerava a safra de 1986 "muito boa, às vezes excepcional". Ashenfelter a achava medíocre. E cravou que 1989 seria "o vinho do século", e que 1990 seria ainda melhor.
Nos leilões, a safra de 1989 chegou a ser vendida por mais que o dobro do preço da de 1986. A de 1990, por mais ainda.
A ferramenta por trás dessas previsões é uma das mais simples da estatística: a regressão linear. Neste artigo, vamos refazer o modelo de Ashenfelter em Python, com os dados originais, e ver o que ele ensina sobre decisões com dados.
Regressão linear em uma frase
A regressão linear encontra a reta que passa mais perto de um conjunto de pontos.
De um lado está o que queremos prever, a variável dependente: aqui, o preço do vinho. Do outro estão as variáveis independentes, que usamos para prever: temperatura, chuva, idade.
Com uma variável só, dá para ver a ideia num gráfico. Cada ponto abaixo é uma safra de Bordeaux, entre 1952 e 1978:
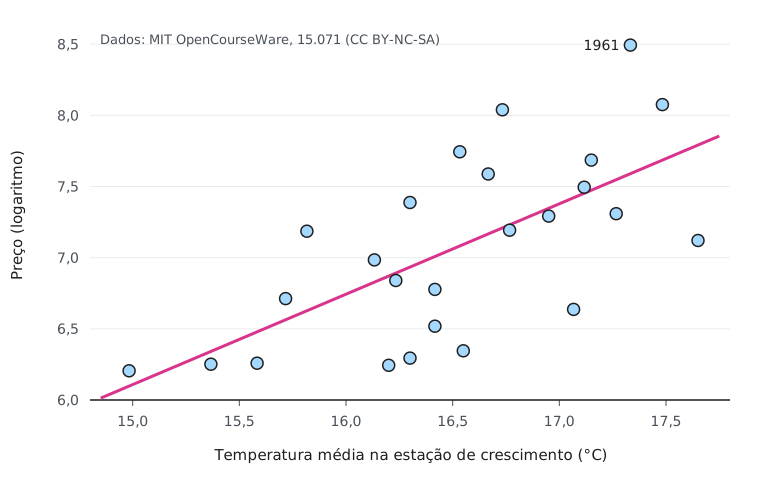
A tendência é clara: anos mais quentes dão vinhos mais caros. A reta magenta é a que a regressão escolheu: entre todas as retas possíveis, é a que tem a menor soma dos erros ao quadrado, ou seja, a menor distância total até os pontos.
Mas repare que muitos pontos ficam longe da reta. A temperatura explica parte da história, não toda.
Para medir quanto ela explica, usamos o R². Ele vai de 0 a 1:
- 0 quer dizer que o modelo não é melhor do que chutar o preço médio para todas as safras;
- 1 quer dizer que o modelo acerta tudo.
A temperatura sozinha tem R² de 0,44: explica 44% da variação de preço entre as safras.
Mão na massa: o modelo em Python
Os dados que Ashenfelter usou estão disponíveis no curso The Analytics Edge do MIT OpenCourseWare, que usa esse caso para ensinar regressão. Vamos precisar de duas bibliotecas:
pip install pandas statsmodelsO curso separa os dados em dois arquivos: 25 safras (1952 a 1978) para construir o modelo, e 2 safras (1979 e 1980) guardadas para testar depois.
import pandas as pd
import statsmodels.formula.api as smf

MIT = "https://ocw.mit.edu/courses/15-071-the-analytics-edge-spring-2017/"
safras = pd.read_csv(MIT + "e6eb689583a501e5b4c6164d771880d9_wine.csv")
novas = pd.read_csv(MIT + "fbf05b0e868bc87b4fbadac6fe406c30_wine_test.csv")

print(safras.head())
Cada linha é uma safra, com estas colunas:
| Coluna | O que é |
|---|---|
Price | Preço típico da safra em leilões de 1990 e 1991, em logaritmo |
AGST | Temperatura média na estação de crescimento da uva (°C) |
HarvestRain | Chuva na época da colheita (mm) |
WinterRain | Chuva no inverno anterior (mm) |
Age | Idade da safra (anos) |
FrancePop | População da França no ano da safra (milhares) |
O preço vem em logaritmo porque os preços de vinho variam demais entre safras: uma pode valer dez vezes mais que outra. Na escala logarítmica, a relação com o clima fica mais próxima de uma reta, e cada coeficiente vira uma variação percentual, como vamos ver.
Primeiro, o modelo do gráfico, só com a temperatura:
modelo_1 = smf.ols("Price ~ AGST", data=safras).fit()
print(round(modelo_1.rsquared, 2))  # 0.44
A fórmula "Price ~ AGST" se lê como "o preço em função da temperatura". Para usar mais variáveis, basta somá-las:
modelo = smf.ols("Price ~ AGST + HarvestRain + Age + WinterRain", data=safras).fit()
print(round(modelo.rsquared, 2))  # 0.83
print(modelo.params)
Cada variável que entra aumenta o R²:
| Variáveis | R² |
|---|---|
| Temperatura | 0,44 |
| + chuva na colheita | 0,71 |
| + idade | 0,79 |
| + chuva no inverno | 0,83 |
Com quatro números sobre o clima e a idade, o modelo explica 83% da variação de preço entre as safras. Sem provar uma gota.
Para ver o relatório completo, com erros padrão e testes de significância, use print(modelo.summary()).
Lendo os coeficientes
O modelo.params mostra quanto cada variável pesa:
Intercept     -3.429980
AGST           0.607209
HarvestRain   -0.003972
Age            0.023931
WinterRain     0.001076
Como o preço está em logaritmo, cada coeficiente se traduz numa variação percentual. A conta é exp(coeficiente × variação) − 1, e o resultado fica assim:
| Se... | o preço da safra... |
|---|---|
| a estação de crescimento for 1 °C mais quente | sobe cerca de 84% |
| chover 100 mm a mais na colheita | cai cerca de 33% |
| chover 100 mm a mais no inverno | sobe cerca de 11% |
| a safra for 1 ano mais velha | sobe cerca de 2,4% |
Tudo isso considerando as outras variáveis constantes, e faz sentido para quem entende de uva: verão quente amadurece a fruta, chuva na colheita dilui o suco, chuva no inverno abastece o solo para a estação de crescimento, e vinho de guarda valoriza com o tempo.
Esse é um dos grandes trunfos da regressão linear: o modelo pode ser lido e discutido. Não é uma caixa-preta. Um produtor pode olhar para essa tabela e decidir se concorda.
O teste de verdade: safras que o modelo nunca viu
Um R² de 0,83 parece ótimo, mas ele mede o acerto nas mesmas safras usadas para construir o modelo. É como corrigir a própria prova.
O teste que importa é com dados novos. É para isso que servem as safras de 1979 e 1980:
def r2_fora_da_amostra(modelo, novas, safras):
    previsto = modelo.predict(novas)
    erro_modelo = ((novas.Price - previsto) ** 2).sum()
    erro_media = ((novas.Price - safras.Price.mean()) ** 2).sum()
    return 1 - erro_modelo / erro_media

print(round(r2_fora_da_amostra(modelo, novas, safras), 2))  # 0.79
Repetindo o teste para cada combinação de variáveis:
| Variáveis | R² nas 25 safras | R² nas 2 safras novas |
|---|---|---|
| Temperatura | 0,44 | 0,79 |
| + chuva na colheita | 0,71 | −0,08 |
| + idade | 0,79 | 0,53 |
| + chuva no inverno | 0,83 | 0,79 |
| + população da França | 0,83 | 0,76 |
Duas lições saem dessa tabela:
- Melhor ajuste não garante melhor previsão. O modelo com temperatura e chuva na colheita sobe para 0,71 nos dados de treino, mas erra mais que a média nas safras novas: o R² fica negativo, algo que só pode acontecer fora da amostra.
- Duas safras são muito pouco para concluir qualquer coisa. Com uma amostra desse tamanho, um único ano atípico muda tudo. O próprio curso do MIT faz essa ressalva.
Cuidados antes de confiar no modelo
Correlação não é causa. Repare na última linha da tabela: a população da França. Sozinha, ela tem R² de 0,22 com o preço do vinho. Os franceses não deixam o vinho mais caro por nascerem: a população cresceu ano após ano, então ela "anda junto" com a idade da safra (a correlação entre as duas é de −0,99). A regressão não sabe disso. Quem precisa saber é você.
Poucos dados, cuidado em dobro. São 25 safras. Cada variável a mais é mais um número que o modelo precisa estimar com a mesma pouca informação. Foi o que aconteceu com a população da França: ela não melhorou o R² e ainda piorou o teste.
Não extrapole. Os dados vão de 15 a 17,7 °C. O modelo não sabe o que acontece num verão de 20 °C, e a reta certamente não continua subindo para sempre: calor demais também estraga a uva.
Nem toda relação é uma reta. A regressão linear assume que cada grau a mais tem o mesmo efeito. Quando isso não vale, é hora de transformar as variáveis, como fizemos com o logaritmo do preço, ou de usar outro modelo.
Por que isso é sobre decisões
A história de Ashenfelter não é sobre vinho. É sobre o que acontece quando um modelo simples e transparente encontra a opinião de especialistas.
O modelo não substituiu o paladar de ninguém. Ele fez algo mais útil: deu a produtores e compradores uma estimativa antecipada, objetiva e verificável, num mercado em que a qualidade de uma safra só fica clara depois de anos na garrafa.
Essa é a melhor forma de pensar em dados para decisão: antes de qualquer modelo sofisticado, perguntar quais poucas variáveis explicam a maior parte do problema e testar essa resposta com dados que o modelo nunca viu.