Esta é a parte 2 de Como construir um agente LangGraph com FastAPI e streaming SSE.
Agora temos um agente e uma API HTTP.
A próxima pergunta é:
Como enviamos informações de volta ao cliente enquanto o agente está rodando?
É aqui que entram os Server-Sent Events.
O que é SSE?
Server-Sent Events é um mecanismo simples, baseado em HTTP, que permite ao servidor manter uma conexão aberta e enviar vários eventos ao cliente ao longo do tempo.
Uma resposta SSE básica tem esta cara:
data: {"type": "start"}

data: {"type": "message", "content": "Hello"}

data: {"type": "done"}
Cada evento é separado por uma linha em branco.
No nível do protocolo, a parte importante é:
data: <payload>\n\nA conexão fica aberta enquanto o servidor continua produzindo eventos.
Isso torna o SSE útil para aplicações de IA em que um único pedido pode envolver várias etapas antes de a resposta final ficar disponível.
Por que SSE em vez de uma resposta JSON comum?
Um endpoint de API tradicional segue um modelo simples de requisição e resposta:
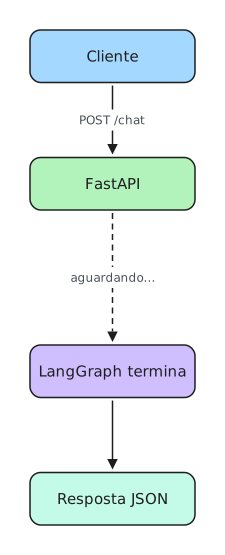
O cliente não recebe nada até a operação inteira terminar.
Com SSE, a resposta vira um fluxo:
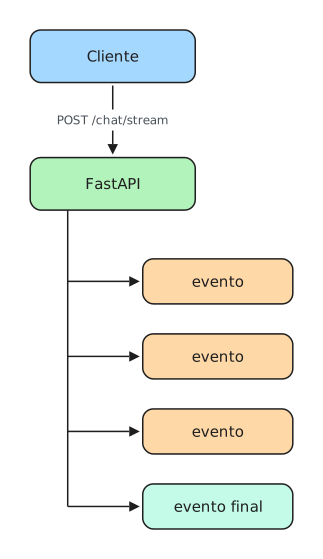
A requisição HTTP continua aberta, mas os dados podem chegar aos poucos.
Para aplicações com agentes, isso abre uma possibilidade importante de arquitetura: o backend pode expor o progresso de uma execução em várias etapas, em vez de tratar o agente como uma caixa-preta.
Streaming a partir do FastAPI
O FastAPI pode devolver uma resposta HTTP em streaming usando StreamingResponse.
Conceitualmente, o padrão é este:
from fastapi.responses import StreamingResponse


async def event_stream():
    yield 'data: {"type": "start"}\n\n'

    # Execute algum trabalho assíncrono aqui.

    yield 'data: {"type": "done"}\n\n'


return StreamingResponse(
    event_stream(),
    media_type="text/event-stream",
)
A ideia central é que event_stream() é um gerador assíncrono.
Em vez de montar a resposta completa na memória e devolvê-la de uma vez, o gerador pode fazer yield de partes da resposta à medida que a execução avança.
O FastAPI envia essas partes pela conexão HTTP aberta.
Isso nos dá esta relação:
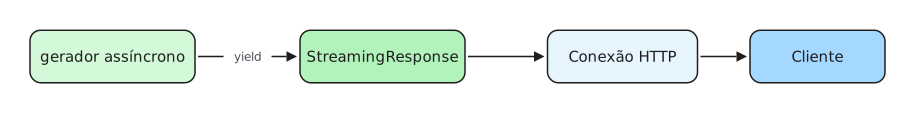
No caso do SSE, cada mensagem enviada com yield segue o formato event-stream.
Conectando o stream ao LangGraph
A parte útil começa quando o gerador assíncrono é conectado ao grafo.
Em vez de produzir mensagens arbitrárias, o endpoint executa o fluxo do LangGraph e converte os resultados relevantes da execução em mensagens SSE.
Conceitualmente:
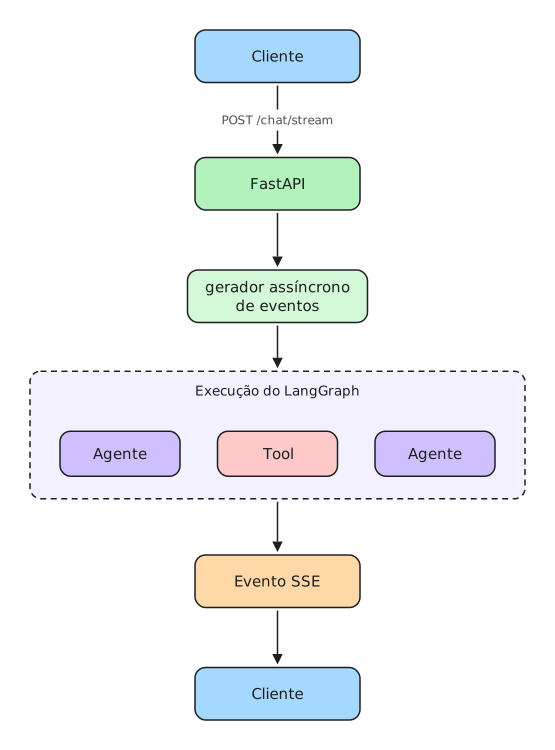
Vale a pena preservar essa separação.
O LangGraph não deveria precisar saber nada sobre HTTP ou SSE.
Da mesma forma, a camada HTTP não deveria conter a lógica de raciocínio do agente.
O grafo produz o comportamento da aplicação.
A camada de API traduz esse comportamento num protocolo que o cliente consegue consumir.
De forma simplificada:
async def event_stream():
    async for event in graph_execution:
        yield format_as_sse(event)
Essa pequena fronteira é uma das ideias mais úteis desta arquitetura.
Ela significa que o mesmo grafo poderia, depois, ser consumido por outra interface, sem reescrever o agente.
SSE não é automaticamente streaming de tokens
Há uma distinção importante aqui.
Transmitir uma resposta HTTP com SSE não significa, automaticamente, que o modelo de linguagem está transmitindo tokens.
São preocupações separadas.
O SSE descreve como o servidor envia dados ao cliente.
O streaming de tokens do LLM descreve como a saída do modelo fica disponível durante a geração.
Considere estas duas arquiteturas.
Streaming de eventos
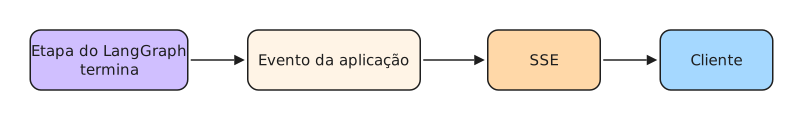
O cliente recebe informações quando eventos relevantes da aplicação ficam disponíveis.
Streaming de tokens
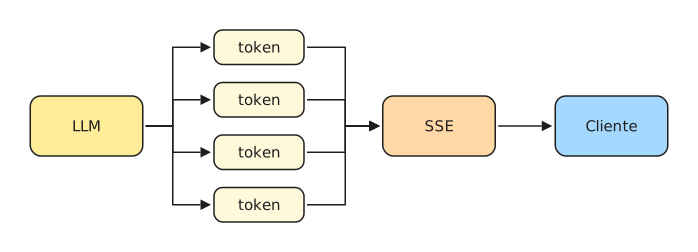
Aqui, partes do texto gerado pelo modelo são repassadas à medida que são produzidas.
As duas abordagens podem usar SSE.
Mas não são a mesma coisa.
Este tutorial foca no comportamento de streaming implementado pela aplicação de exemplo, sem afirmar que cada mensagem SSE representa um token individual do modelo.
Essa distinção se torna importante ao projetar frontends e medir a latência percebida.
Por que essa fronteira importa
É tentador colocar tudo dentro do endpoint FastAPI:
receber o pedido
→ chamar o modelo
→ decidir a tool
→ chamar a API
→ chamar o modelo de novo
→ formatar a resposta
→ transmitir a resposta
Isso funciona para aplicações bem pequenas.
Mas logo fica difícil de manter.
Com o LangGraph, a orquestração fica dentro do grafo:
LangGraph
   │
   ├── raciocínio
   ├── decisões de tool
   ├── execução de tools
   └── transições de estado
O FastAPI continua responsável pelo transporte:
FastAPI
   │
   ├── validação do pedido
   ├── endpoint HTTP
   └── resposta em streaming
E o SSE continua responsável por entregar as informações aos poucos:
SSE
   │
   └── eventos servidor → cliente
A arquitetura completa fica assim:
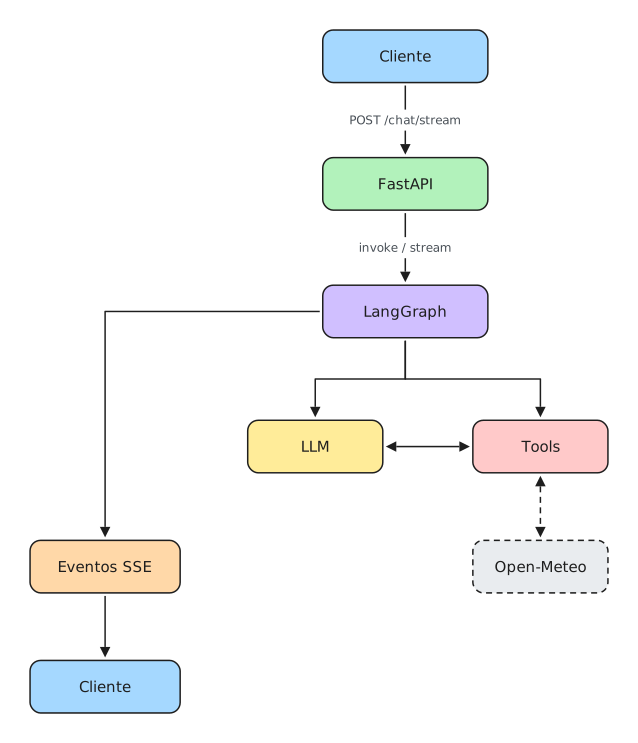
Neste ponto, todas as peças principais estão conectadas.
Agora podemos rodar a aplicação e acompanhar o fluxo completo de um pedido.
Rodando a aplicação
Depois de clonar o repositório que acompanha o artigo, instale as dependências do projeto e configure o ambiente exigido pela aplicação.
Em seguida, inicie o servidor FastAPI.
Com a API rodando, você pode testar primeiro o endpoint de chat comum.
Isso é útil porque separa duas perguntas:
- O agente funciona?
- O streaming funciona?
Se o endpoint JSON comum funciona mas o de streaming não, o problema provavelmente está na camada de streaming HTTP, e não no grafo.
Esse é um padrão útil de depuração para aplicações com agentes:
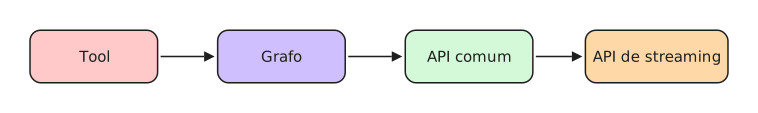
Valide cada camada antes de adicionar a próxima.
Testando o endpoint SSE
Depois, você pode enviar um pedido ao endpoint de streaming usando um cliente que mostre a resposta à medida que ela chega.
O curl é especialmente útil para isso, porque permite inspecionar o stream HTTP bruto sem introduzir código de frontend.
Conceitualmente:
curl -N \
  -X POST \
  -H "Content-Type: application/json" \
  -d '{"message":"Como está o tempo em São Paulo?"}' \
  http://localhost:8000/chat/stream
A opção -N desativa o buffer de saída do curl, deixando os dados transmitidos visíveis assim que chegam.
Em vez de receber um único documento JSON depois que o pedido termina, você deve ver mensagens no formato SSE chegando pela mesma conexão.
Isso é útil por outro motivo: expõe o protocolo diretamente.
Antes de escrever JavaScript, hooks de React, indicadores de carregamento ou componentes de chat, você pode verificar se o backend está mesmo produzindo um stream válido.
Acompanhando um pedido de ponta a ponta
Agora considere o que acontece quando o usuário pergunta:
Como está o tempo em São Paulo?O pedido chega primeiro ao FastAPI.
Usuário
  │
  ▼
POST /chat/stream
O FastAPI valida o pedido e inicia a resposta em streaming.
POST /chat/stream
       │
       ▼
StreamingResponse
A mensagem é passada para a aplicação LangGraph.
StreamingResponse
       │
       ▼
LangGraph
O nó do agente envia o estado atual da conversa ao modelo.
O modelo percebe que, para responder à pergunta, precisa de informações atuais do clima, e pede a tool de clima.
LLM
 │
 │ pedido de tool
 ▼
get_weather
A tool busca a informação externa no Open-Meteo.
get_weather
     │
     ▼
Open-Meteo
     │
     ▼
dados do clima
O resultado volta ao grafo e passa a fazer parte do estado da conversa.
Agora o modelo pode gerar uma resposta usando a informação obtida pela tool.
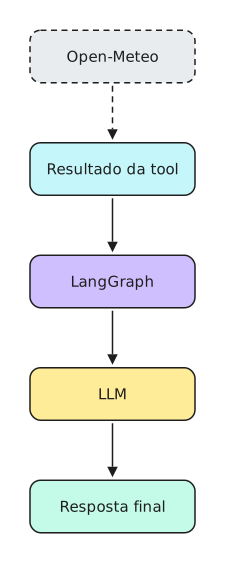
A camada de API converte a saída relevante em dados no formato SSE e os envia pela conexão HTTP aberta.
Resposta final
     │
     ▼
SSE
     │
     ▼
Cliente
Agora conectamos as quatro camadas:
HTTP
  +
orquestração com LangGraph
  +
execução real de tools
  +
transporte em streaming
Essa é a arquitetura central do exemplo.
Mas é igualmente importante entender o que essa arquitetura ainda não oferece.
O que este exemplo ainda não faz
A aplicação é pequena de propósito.
Isso a torna útil para entender a arquitetura, mas também significa que várias preocupações exigidas por sistemas reais de produção ficam fora do escopo deste tutorial.
Autenticação e autorização
A API não representa uma fronteira de segurança completa para uma aplicação com vários usuários.
Um serviço de produção normalmente precisaria identificar quem faz a chamada e determinar quais agentes, tools, conversas e recursos cada usuário pode acessar.
Isso se torna especialmente importante quando as tools podem executar ações, em vez de apenas buscar informações públicas.
Estado persistente da conversa
O exemplo não deve ser tratado como uma arquitetura completa de persistência de conversas.
Aplicações reais muitas vezes precisam de estado durável, para que as conversas sobrevivam a reinícios do processo, escalem entre workers ou possam ser retomadas depois.
O LangGraph oferece mecanismos que podem participar de estratégias de persistência, mas escolher e operar essa camada é uma decisão de arquitetura à parte.
Tratamento de erros em produção
Sistemas externos falham.
Modelos podem estourar o tempo limite.
APIs podem devolver respostas inesperadas.
Clientes podem se desconectar com um stream ativo.
O código de produção precisa tratar explicitamente esses modos de falha e deve expor os erros por um contrato de eventos previsível.
Retentativas e timeouts
Chamar um serviço externo sem uma estratégia deliberada de timeout e retentativa pode criar problemas em cascata sob carga.
Integrações de produção geralmente precisam de políticas para:
timeouts
retries
backoff
rate limits
circuit breaking
A política certa depende da operação.
Repetir uma consulta de clima e repetir uma tool que cria uma transação financeira são decisões muito diferentes.
Observabilidade
Quando um agente tem várias etapas, logs com apenas a resposta final não bastam.
Um sistema de produção normalmente precisa de visibilidade sobre:
pedido
→ execução do grafo
→ chamadas ao modelo
→ chamadas de tools
→ latência
→ erros
→ resultado final
O tracing se torna especialmente valioso quando o modelo escolhe dinamicamente quais tools executar.
Escalabilidade
Um processo FastAPI rodando localmente não é, por si só, uma arquitetura de deploy.
Conexões de streaming de longa duração afetam os recursos do servidor, a configuração dos workers, proxies, load balancers e plataformas de deploy.
Essas restrições precisam ser consideradas antes de expor endpoints SSE em escala.
Um contrato de eventos estável
Assim que um frontend depende do stream, os eventos SSE viram um contrato de API.
Em vez de emitir payloads arbitrários, uma aplicação maior geralmente se beneficia de tipos de evento explícitos, como:
{"type": "started"}{"type": "tool_started", "tool": "get_weather"}{"type": "tool_completed", "tool": "get_weather"}{"type": "message", "content": "..."}{"type": "completed"}{"type": "error", "message": "..."}O esquema exato depende da aplicação.
O ponto importante é que o próprio stream deve, em algum momento, ser tratado como uma interface versionada entre backend e cliente.
Do exemplo à arquitetura de produção
O exemplo nos dá uma base útil:
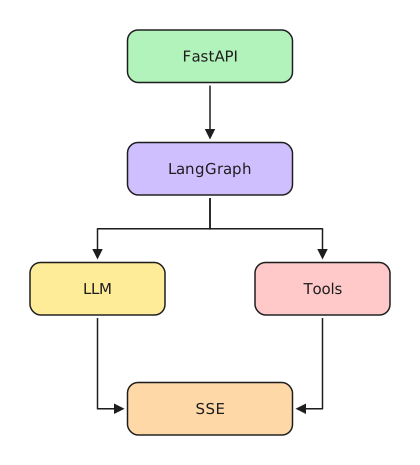
Um sistema mais completo pode acabar evoluindo para algo assim:
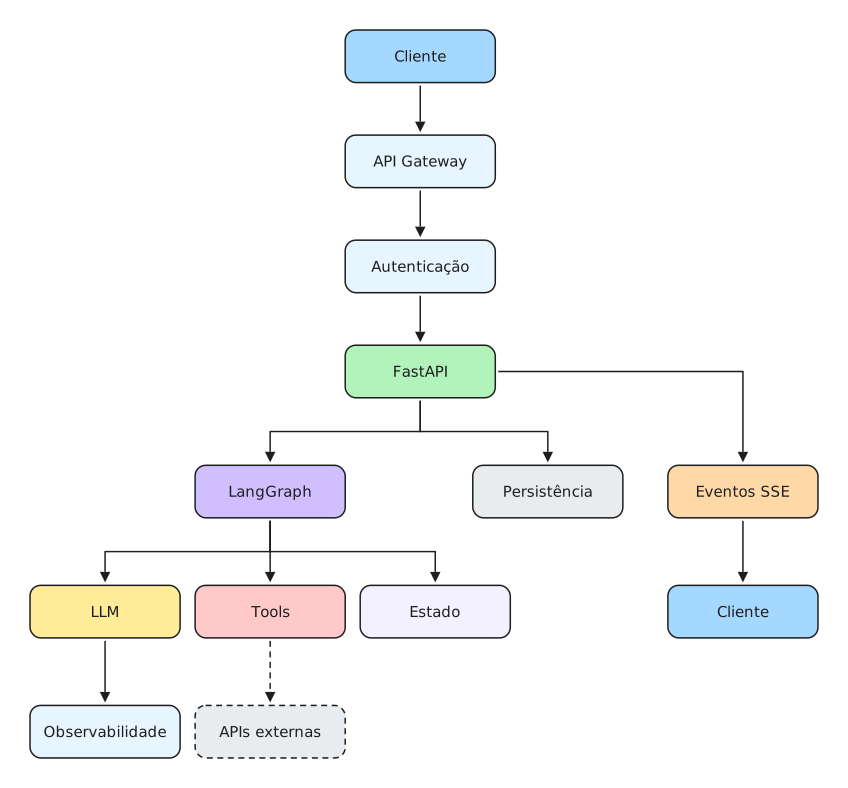
Você não deve construir tudo isso antes de precisar.
O valor do exemplo pequeno está justamente em nos deixar entender primeiro o caminho central de execução.
Com esse caminho claro, as capacidades de produção podem ser adicionadas porque um requisito concreto as exige, e não só porque aparecem num diagrama de arquitetura.
Próximos passos
Começamos com um objetivo simples:
Expor um agente LangGraph pelo FastAPI e transmitir sua execução com Server-Sent Events.
No caminho, separamos a aplicação em responsabilidades claras.
O LangGraph gerencia o fluxo do agente.
As tools conectam o modelo a capacidades externas.
O FastAPI fornece a fronteira HTTP.
O SSE dá ao servidor um mecanismo simples para enviar eventos aos poucos de volta ao cliente.
A arquitetura resultante é pequena o bastante para ser entendida, mas útil o bastante para servir de ponto de partida para aplicações com agentes mais capazes.
A partir daqui, extensões úteis incluem estado persistente da conversa, esquemas estruturados de eventos SSE, autenticação, melhor tratamento de falhas, observabilidade, mais tools e, quando a experiência do usuário exigir, streaming real de tokens do modelo.
O importante não é adicionar todos esses recursos de imediato.
É entender onde cada um se encaixa.
É isso que torna a arquitetura extensível.
Código-fonte
O exemplo completo usado neste tutorial está disponível no GitHub:
salada-dados/langgraph-fastapi-example
Clone, rode localmente, troque a tool, inspecione o stream SSE e depois comece a modificar o grafo.
Ler sobre uma arquitetura de agente é útil.
Quebrar uma e reconstruí-la costuma ser onde o entendimento de verdade começa.
Seu agente funciona. E agora, o que acontece em produção?
A esta altura, o agente funciona.
Ele chama uma tool real, expõe uma API pelo FastAPI e envia eventos de volta ao cliente por streaming.
Mas fazer um agente funcionar é só o começo.
O que acontece quando o LLM dá timeout?
E se uma tool falhar no meio da execução?
E se uma retentativa executar a mesma tool duas vezes?
Onde fica o estado da conversa quando o processo reinicia?
O que acontece quando o cliente se desconecta durante uma requisição longa?
E quando algo dá errado, como você descobre o que o agente realmente fez?
Esses problemas são diferentes de construir o agente em si.
São problemas de engenharia de produção.
No Salada de Dados, essa é a próxima camada que estamos explorando: como pegar agentes de IA que funcionam localmente e torná-los confiáveis o bastante para rodar em sistemas reais.
Vamos focar em problemas como:
- estado e persistência;
- falhas e retentativas;
- idempotência;
- observabilidade e depuração;
- streaming e conexões interrompidas;
- testes e avaliação;
- segurança e deploy.
E vamos abordá-los com o mesmo princípio deste tutorial: primeiro implementações que funcionam, depois a arquitetura explicada a partir do código — não diagramas abstratos.
Se você está construindo agentes de IA e começando a enfrentar esses problemas, entre no acesso antecipado do Salada de Dados.
Estamos usando o acesso antecipado para entender com quais problemas de produção os desenvolvedores mais estão sofrendo e para definir o que vamos construir em seguida.
A IA pode ajudar você a escrever o agente.
O próximo desafio é fazê-lo sobreviver à produção.