Pergunte a qualquer assistente de IA como dividir documentos para um RAG e a resposta vai ser parecida: pedaços de 500 a 1000 tokens, com 10% a 20% de sobreposição.
É uma resposta plausível. Está em centenas de tutoriais. E quase ninguém mostra se ela funciona.
Então testamos. Pegamos uma lei de verdade, escrevemos 32 perguntas com resposta conhecida e comparamos sete jeitos de cortar o texto, em português e em inglês.
A receita padrão ficou entre as piores. A melhor estratégia acertou mais e mandou quatro vezes menos texto para o LLM.
O código completo, com os dados e as perguntas, está em salada-dados/blog. Tudo roda de graça, na sua máquina, sem chave de API.
RAG em uma frase
Um RAG (Retrieval-Augmented Generation) busca os trechos certos de um documento e só então pede ao LLM que responda, usando esses trechos.
Na prática, são quatro passos:
- Cortar o documento em pedaços (chunks).
- Transformar cada pedaço num vetor (embedding) e guardar num banco.
- Quando chega uma pergunta, transformar a pergunta num vetor e buscar os pedaços mais parecidos.
- Mandar esses pedaços ao LLM, junto com a pergunta.
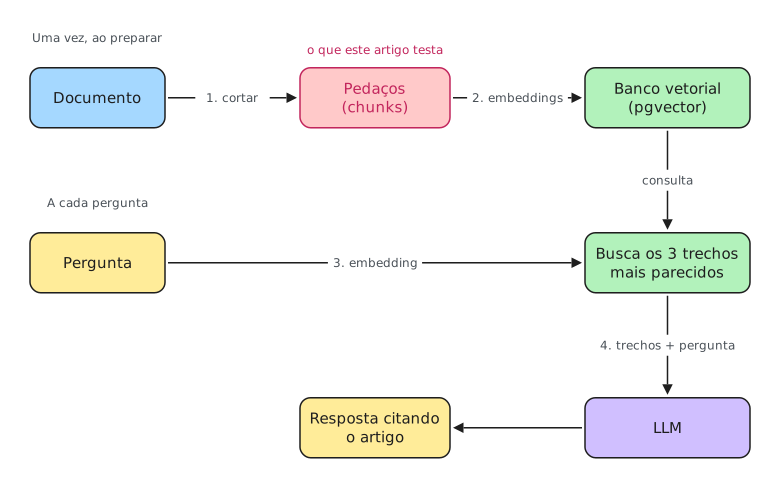
Se o passo 3 trouxer o trecho errado, o LLM vai responder com confiança, mas a partir do texto errado. Por isso este artigo mede só a busca: sem o trecho certo, nenhum LLM salva a resposta.
E a busca depende muito do passo 1, que costuma ser decidido no chute.
O documento: o GDPR
Usamos o GDPR, o regulamento europeu de proteção de dados que inspirou a nossa LGPD. Ele é um bom teste por três motivos:
- Tem tamanho de documento real: 99 artigos, 389 números (os parágrafos numerados de cada artigo), entre 40 e 45 mil tokens, conforme a língua.
- Tem estrutura: artigo, número, alínea. Dá para comparar "cortar por tamanho" com "cortar pela estrutura".
- Tem versão oficial em português e em inglês, com o mesmo artigo no mesmo lugar. Então o mesmo experimento roda nas duas línguas.
O script download_gdpr.py baixa as duas versões do EUR-Lex e separa os artigos num JSON.
Um detalhe que vai importar: a versão em português da UE é português de Portugal. "Autoridade de controlo", "subcontratante", "facto".
O modelo de embeddings
Para tudo rodar de graça, usamos o multilingual-e5-small: pequeno (cerca de 470 MB), roda em CPU e entende português e inglês.
Duas características dele mudam o experimento:
- Ele lê no máximo 512 tokens. O que passar disso é ignorado, sem erro e sem aviso. Por isso a receita de 1000 tokens nem entrou no teste: metade do pedaço seria jogada fora.
- Ele foi treinado com prefixos:
query:antes da pergunta epassage:antes do trecho. Sem eles, a busca piora. É o tipo de detalhe que o código gerado por IA costuma esquecer.
passages = model.encode(["passage: " + t for t in texts], normalize_embeddings=True)
queries = model.encode(["query: " + q for q in questions], normalize_embeddings=True)
Sete jeitos de cortar
Por tamanho, sem olhar a estrutura do texto:
- Fixo de 128, 256 e 512 tokens: junta a lei inteira e corta a cada N tokens.
- 500 tokens com sobreposição de 64 ou 128: a receita padrão. Cada pedaço repete o final do anterior, para não perder o que caiu na borda.
Pela estrutura do documento:
- Por artigo: um pedaço por artigo.
- Por número: um pedaço por parágrafo numerado, com o título do artigo no começo.
- Por alínea: igual ao anterior, mas um número longo demais vira um pedaço por alínea, (a), (b), (c)...
O título do artigo no começo de cada pedaço não é enfeite. Um parágrafo como "2. O subcontratante notifica o responsável pelo tratamento..." não diz sozinho que o assunto é vazamento de dados. O título "Artigo 33: Notificação de uma violação de dados pessoais" diz.
A estratégia por alínea é a mais trabalhosa, e mesmo assim cabe em poucas linhas:
def by_point(articles, lang, limit=400):
    chunks = []
    for a in articles:
        head = header(a, lang)  # "Artigo 33: Notificação de uma violação..."
        for p in a["paragraphs"]:
            lines = p.split("\n")
            if n_tokens(p) <= limit or len(lines) == 1:
                chunks.append((head + "\n" + p, {a["article"]}))
            else:
                intro, points = lines[0], lines[1:]
                chunks += [(head + "\n" + intro + "\n" + pt, {a["article"]}) for pt in points]
    return chunks
Como medir sem achismo
Escrevemos 32 perguntas do jeito que uma pessoa comum perguntaria, sem copiar as palavras da lei. Para cada uma, anotamos o artigo que tem a resposta:
{
  "pt": "Uma empresa vazou meus dados. Em quanto tempo ela precisa avisar a autoridade?",
  "en": "A company leaked my data. How long does it have to notify the authority?",
  "articles": [33]
}
Com isso, dá para medir cada estratégia com dois números:
- Acerto no top 3: em quantas perguntas um trecho do artigo certo aparece entre os 3 primeiros resultados. Três porque é o que vamos mandar ao LLM.
- Tokens ao LLM: quanto texto esses 3 trechos somam. É o que você paga (em dinheiro ou em tempo) a cada pergunta.
Um último cuidado: nos cortes por tamanho, onde cai o primeiro corte é sorte. Por isso rodamos cada tamanho quatro vezes, deslocando o ponto de partida, e mostramos a média e a faixa.
Resultados
| Estratégia | Acerto no top 3 (pt) | Acerto no top 3 (en) | Tokens ao LLM |
|---|---|---|---|
| Fixo 128 | 52% (47–62) | 71% (69–78) | ~380 |
| Fixo 256 | 46% (41–56) | 69% (62–72) | ~760 |
| Fixo 512 | 49% (44–53) | 62% (53–69) | ~1.480 |
| 500 + sobreposição de 64 | 44% | 56% | ~1.490 |
| 500 + sobreposição de 128 | 41% | 66% | ~1.490 |
| Por artigo | 59% | 62% | ~1.000 a 1.600 |
| Por número | 66% | 81% | ~400 |
| Por alínea | 69% | 84% | ~350 |
A estratégia por alínea venceu nas duas línguas e é a que manda menos texto ao LLM. A receita padrão ficou no fim da tabela, gastando quatro vezes mais.
Mas os números mais interessantes estão nos detalhes.
O que a tabela esconde
A sorte do corte pesa tanto quanto o tamanho
Olhe a faixa do fixo de 128 em português: de 47% a 62%. Nada mudou além do ponto onde caiu o primeiro corte.
Essa variação é maior que a diferença entre 128, 256 e 512 tokens. Ou seja: com cortes por tamanho, comparar tamanhos é quase medir ruído. Quem testa um tamanho só, uma vez, pode concluir qualquer coisa.
Um terço da lei invisível
Com um pedaço por artigo, 30 dos 99 artigos passam de 512 tokens. O modelo lê o começo e ignora o resto.
Somando, cerca de 30% do texto da lei nunca entra na busca. Nenhum erro, nenhum aviso: a busca simplesmente não encontra o que está no fim dos artigos longos.
O caso mais extremo é o artigo 4, o das definições. No original, ele é um único número com 26 definições e mais de 2.700 tokens. Mesmo cortando por número, só a primeira parte é lida, e a pergunta "O que conta como dado pessoal?" erra em inglês. Cortando por alínea, cada definição vira um pedaço, e o problema some.
Português perde de 10 a 20 pontos
Em todas as estratégias, o inglês acerta mais. Olhando as perguntas que erraram, o motivo é quase sempre vocabulário:
| A pergunta diz | A lei diz |
|---|---|
| terceiriza o processamento | subcontratante |
| cadastro com informações erradas | dados inexatos, retificação |
| propaganda personalizada | comercialização direta |
| loja americana | estabelecimento, oferta de bens ou serviços |
As perguntas estão em português do Brasil e em linguagem leiga. A lei está em português de Portugal e em juridiquês. Em inglês, a distância entre "leaked my data" e "personal data breach" é menor.
Isso vale para qualquer RAG em português: se o seu usuário fala diferente do documento, a busca sofre, e trocar o tamanho do pedaço não resolve.
Fechando o ciclo: pgvector e um LLM local
Com a estratégia escolhida, o resto é o RAG de sempre. O docker-compose.yml do repositório sobe o PostgreSQL com pgvector e o Ollama, que roda o LLM localmente:
docker compose up -d
docker compose exec ollama ollama pull qwen2.5:3b
python index.py
O index.py corta a lei por alínea e grava cada pedaço com o seu vetor. A busca é uma consulta SQL: o operador <=> calcula a distância de cosseno.
def search(lang: str, question: str, k: int = 3):
    vector = model.encode("query: " + question, normalize_embeddings=True)
    with psycopg.connect(DSN) as conn:
        register_vector(conn)
        return conn.execute(
            """SELECT article, content, 1 - (embedding <=> %s) AS similarity
               FROM chunks WHERE lang = %s
               ORDER BY embedding <=> %s LIMIT %s""",
            (vector, lang, vector, k),
        ).fetchall()
Os 3 trechos vão para o LLM com uma instrução simples: responder só com base neles, citar o artigo e dizer quando não encontrar a resposta. Fazendo a pergunta do começo do artigo:
$ python ask.py pt "Uma empresa vazou meus dados. Em quanto tempo ela precisa avisar a autoridade?"
[0.880] art. 33: 1. Em caso de violação de dados pessoais, o responsável pelo tratamento notifica...
[0.869] art. 77: 1. Sem prejuízo de qualquer outra via de recurso administrativo ou judicial...
[0.865] art. 34: 4. Se o responsável pelo tratamento não tiver já comunicado a violação...

De acordo com o Artigo 33 do GDPR, a empresa precisa notificar a autoridade de controlo no prazo
de 72 horas após ter tido conhecimento da violação de dados pessoais, a menos que a violação não
seja suscetível de resultar num risco para os direitos e liberdades das pessoas singulares.
Resposta certa, com o artigo certo. Agora uma das perguntas que a busca errou:
$ python ask.py pt "Se a empresa terceiriza o processamento, precisa de contrato com o fornecedor?"
[0.853] art. 15: 3. O responsável pelo tratamento fornece uma cópia dos dados pessoais...
[0.850] art. 13: 2. Para além das informações referidas no n.o 1, aquando da recolha...
[0.847] art. 12: 3. O responsável pelo tratamento fornece ao titular as informações...

Não encontrou.
A resposta está no artigo 28, que fala em "subcontratante", e a busca não chegou lá. O LLM fez a coisa certa, que é admitir que não encontrou em vez de inventar. Mas para quem perguntou, o RAG falhou. É a busca, e não o modelo, que decide o teto da resposta.
Cuidados antes de generalizar
32 perguntas é pouco. Cada pergunta vale cerca de 3 pontos. Diferenças de 5 pontos podem ser sorte; as de 25 pontos, como entre a receita padrão e o corte por alínea, dificilmente são.
O resultado vale para este documento. Uma lei tem estrutura explícita. Um contrato escaneado, uma transcrição de reunião ou um fórum não têm, e lá o corte por tamanho pode ser a única opção.
Fomos generosos com os cortes por tamanho. Um pedaço de 512 tokens que pega o fim de um artigo e o começo do outro conta como acerto para os dois. Mesmo assim, perderam.
Busca boa não garante resposta boa. Medimos se o trecho certo chega ao LLM. O que ele faz com o trecho é outro experimento.
Como repetir no seu documento
O resultado que mais vale levar daqui não é "corte por alínea". É o método:
- Escreva de 30 a 50 perguntas reais, do jeito que seus usuários perguntariam, e anote onde está cada resposta.
- Meça a busca antes de mexer no LLM. Acerto no top K e tokens enviados já contam a maior parte da história.
- Teste a estrutura do seu documento contra cortes por tamanho. Seções, cláusulas, perguntas de um FAQ: tudo isso é uma fronteira natural.
- Confira os limites do seu modelo de embeddings (tamanho máximo e prefixos) antes de escolher o tamanho do pedaço.
Escrever as perguntas é a parte chata, e é aqui que um assistente de IA ajuda de verdade. Um ponto de partida:
Vou te passar um documento. Escreva 40 perguntas que um usuário comum faria sobre ele,
com as palavras do dia a dia, e não com os termos do documento. Para cada pergunta,
indique a seção que contém a resposta. Inclua perguntas difíceis: as que usam sinônimos,
as que dependem de uma definição e as que o documento não responde.
Revise as perguntas e as respostas antes de usar. É o seu gabarito: se ele estiver errado, o experimento inteiro mede a coisa errada.
Próximos passos
Este artigo é a parte 1 de uma série sobre RAG.
A lei é um documento comportado: só texto, com estrutura clara. Na parte 2, vamos para o mundo real: PDFs com tabelas e imagens, e o que se perde no caminho até o texto.
Depois, na parte 3, esse banco vira uma ferramenta de um agente, via MCP, continuando a série de LangGraph com FastAPI.