"IA", "machine learning", "deep learning" e "LLM" aparecem nas notícias como se fossem sinônimos.
Não são. Um cabe dentro do outro, como bonecas russas:
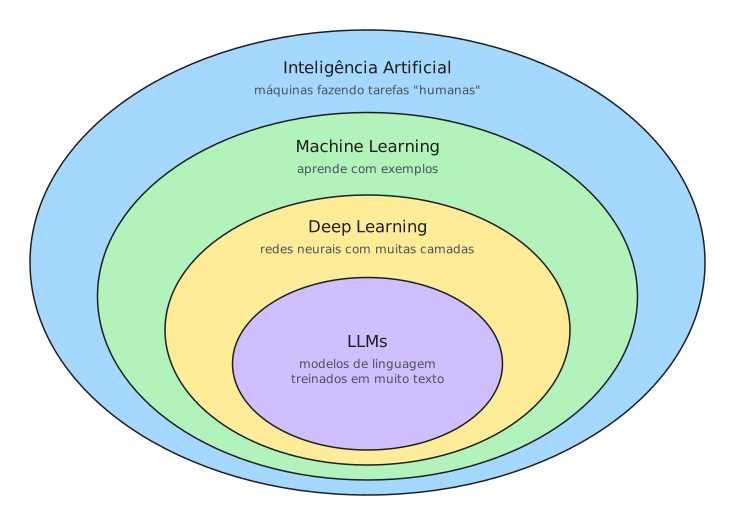
Todo LLM é deep learning, todo deep learning é machine learning, e todo machine learning é IA. O contrário não vale.
Neste artigo, vamos abrir cada boneca: o que ela é, quando surgiu e o que mudou com ela. No caminho, fica claro por que a IA virou uma corrida por chips e data centers.
IA: o guarda-chuva
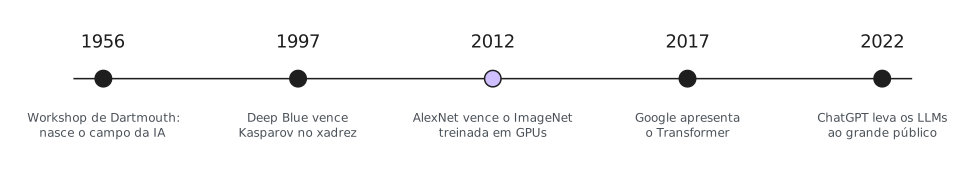
O termo "inteligência artificial" nasceu em 1955, na proposta de um workshop de verão em Dartmouth, nos Estados Unidos, realizado no ano seguinte. A ideia era ambiciosa: fazer máquinas resolverem problemas que, até então, só pessoas resolviam.
IA é, portanto, o objetivo, não uma técnica. Cabe nela qualquer sistema que faça algo que pareça inteligente: jogar xadrez, traduzir um texto, reconhecer um rosto, planejar uma rota.
Durante décadas, o caminho principal foi escrever as regras à mão. Especialistas descreviam o conhecimento em forma de "se isso, então aquilo", e o programa seguia as regras.
O exemplo mais famoso dessa fase é o Deep Blue, da IBM, que venceu o campeão mundial de xadrez Garry Kasparov em 1997. Ele não aprendeu a jogar como os sistemas de hoje: combinava hardware especializado, que analisava mais de 100 milhões de posições por segundo, com uma função de avaliação de milhares de critérios de xadrez, calibrada com partidas de mestres e ajustada por um grande mestre.
Funciona bem quando as regras cabem num manual. O problema é que a maior parte do mundo não cabe.
Machine learning: aprender com exemplos
Tente escrever as regras para decidir se alguém vai pagar um empréstimo. Renda, idade, histórico, emprego, dívidas... As combinações explodem, e as regras que funcionam hoje mudam amanhã.
O machine learning inverte a lógica: em vez de escrever as regras, você mostra exemplos e deixa o algoritmo descobrir o padrão. O termo foi popularizado em 1959 por Arthur Samuel, que fez um programa de damas melhorar jogando contra si mesmo.
No caso do empréstimo, os exemplos são o histórico de clientes: quem pagou e quem não pagou. O algoritmo encontra a função que melhor separa um grupo do outro e aplica essa função aos clientes novos.
Existem três formas principais de aprender:
- Supervisionado: os exemplos vêm com a resposta certa ("pagou" ou "não pagou"). É o caso mais comum: previsão de vendas, detecção de fraude, classificação de e-mails.
- Não supervisionado: não há resposta, e o algoritmo procura estrutura nos dados, como grupos de clientes parecidos.
- Por reforço: o sistema aprende por tentativa e erro, recebendo recompensas. O programa de damas de Samuel foi um precursor dessa ideia, que hoje aparece em robôs e jogos.
Os algoritmos clássicos (regressão, árvores de decisão, random forest, gradient boosting) continuam muito vivos. Em dados de tabela, aquele tipo que mora em planilha e banco de dados, eles ainda costumam vencer modelos mais sofisticados, pelo menos em bases de tamanho médio, como mostrou um estudo de 2022.
Deep learning: muitas camadas e muita computação
O deep learning é um tipo de machine learning que usa redes neurais com muitas camadas.
Pense numa linha de montagem: cada camada recebe o resultado da anterior, faz uma transformação simples e passa adiante. Numa imagem, as primeiras camadas detectam bordas; as seguintes, formas; as últimas, objetos. O "deep" (profundo) é a quantidade de camadas empilhadas.
O treino funciona com um algoritmo chamado backpropagation, popularizado em 1986: a rede compara a resposta que deu com a resposta certa e ajusta cada camada um pouquinho na direção que diminui o erro. Repetido milhões de vezes, isso faz a rede aprender.
A grande vantagem: a rede descobre sozinha quais características importam. No machine learning clássico, alguém precisa decidir quais colunas entram no modelo. Com deep learning, você entrega a imagem, o áudio ou o texto bruto.
Se a ideia é dos anos 1980, por que só explodiu bem depois? Porque redes profundas precisam de duas coisas que não existiam em quantidade suficiente: dados e computação.
A virada veio em 2012. Uma rede chamada AlexNet venceu a competição de reconhecimento de imagens ImageNet com uma margem enorme: em 15% das imagens a resposta certa ficou fora dos 5 palpites da rede, contra 26% no segundo colocado. Ela foi treinada em duas placas de vídeo da NVIDIA, feitas para jogos.
Placas de vídeo fazem milhares de contas simples em paralelo, exatamente o tipo de conta que redes neurais precisam. A partir dali, a GPU virou a máquina padrão da IA.
LLMs: um modelo, muitas tarefas
Os LLMs (Large Language Models, ou grandes modelos de linguagem) são modelos de deep learning treinados em quantidades gigantescas de texto. São eles que estão por trás de ChatGPT, Claude e Gemini.
A peça que faltava apareceu em 2017, num artigo do Google chamado "Attention Is All You Need". Ele apresentou o Transformer, uma arquitetura que olha para todas as palavras de um texto ao mesmo tempo e aprende quais se relacionam com quais. Isso tornou o treino muito mais fácil de paralelizar, ou seja, de distribuir por muitas GPUs.
O treino de um LLM parece simples: prever a próxima palavra de um texto. Feito em escala suficiente, com boa parte da internet, livros e código, essa tarefa obriga o modelo a aprender gramática, fatos, raciocínio e estilo.
A grande mudança está no uso. Até então, cada problema pedia um modelo próprio: um para classificar e-mails, outro para traduzir, outro para resumir. Um LLM faz tudo isso com o mesmo modelo, e você só precisa pedir em linguagem natural.
Em novembro de 2022, o ChatGPT levou isso ao grande público.
Na prática, o que usar?
A boneca mais nova não substitui as outras. Cada camada continua sendo a melhor ferramenta para um tipo de problema:
| Problema | Exemplo | Abordagem mais comum |
|---|---|---|
| Regras claras e estáveis | Calcular imposto, validar um formulário | Programação tradicional |
| Dados de tabela | Prever vendas, risco de crédito, churn | Machine learning clássico |
| Imagem, áudio, sinais | Inspeção visual, transcrição, diagnóstico por imagem | Deep learning |
| Texto e conversa | Resumir documentos, atendimento, extrair dados de contratos | LLM |
Um LLM até consegue analisar uma planilha de vendas, mas um modelo de gradient boosting faz isso mais rápido, mais barato e com resultados que dá para auditar. Usar LLM para tudo é como usar um caminhão para ir à padaria.
Por que isso virou uma corrida
Repare no padrão: cada boneca precisou de mais dados e mais computação que a anterior.
As regras do Deep Blue cabiam num computador especializado. A AlexNet precisou de duas GPUs. Um LLM atual é treinado em milhares de GPUs ao mesmo tempo, durante meses.
E, para os LLMs, a escala não é só um custo: é a receita. Pesquisas publicadas a partir de 2020 mostraram que esses modelos melhoram de forma previsível quando crescem em dados, parâmetros e computação. Quem tem mais computação treina modelos melhores.
É por isso que a conversa sobre IA hoje passa tanto por chips, data centers, energia e investimentos bilionários. Esse é o assunto do pilar Indústria de IA aqui do Salada de Dados.